Benchmark

10 de octubre de 2026 · Daniel Lucas

Benchmark Octubre 2026: ¿Cuál es la inteligencia artificial más poderosa?

¿Qué inteligencia artificial lidera en octubre de 2026? Comparamos Claude Opus 5.5, Claude Sonnet 5.5, GPT-6 Astra, Gemini 4 Argon y otros modelos utilizando el Intelligence Index de Artificial Analysis. Descubre sus puntuaciones, diferencias y qué significan para elegir la IA adecuada.
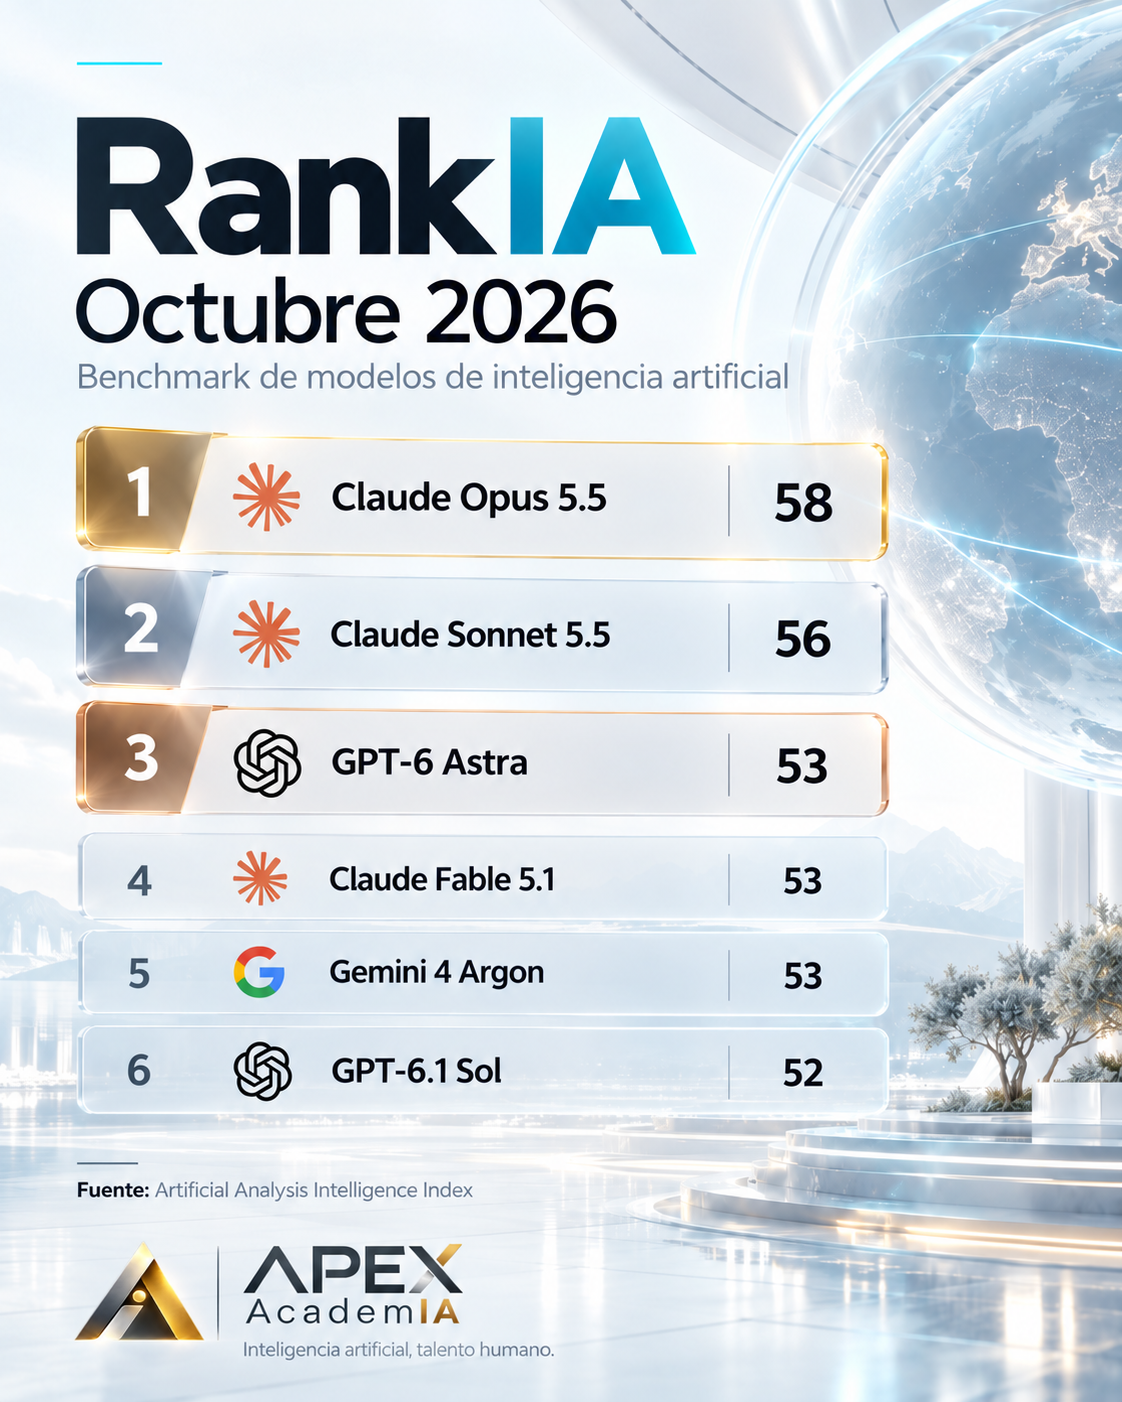
Comparación del ranking

6 posiciones

  1. 01

    Claude Opus 5.5 (Max)

    58
  2. 02

    Claude Sonnet 5.5 (Max)

    56
  3. 03

    GPT-6 Astra (Max)

    53
  4. 03

    Claude Fable 5.1 (Max)

    53
  5. 03

    Gemini 4 Argon (High)

    53
  6. 06

    GPT-6.1 Sol (Max)

    52

Notas del benchmark

**Fecha de publicación:** 10 de octubre de 2026. **Fuente:** Artificial Analysis Intelligence Index v4.3.2. **Fecha de los datos:** 7 de octubre de 2026. **Metodología:** índice compuesto de diez evaluaciones sobre capacidades de los modelos. Se mantienen las configuraciones de esfuerzo indicadas en la clasificación. **Limitaciones:** los resultados son una fotografía del momento, no una clasificación definitiva. Las puntuaciones se redondean, pueden variar según la configuración y no representan porcentajes de respuestas correctas. **Alcance:** ranking de seis modelos seleccionados, no clasificación exhaustiva de todos los modelos existentes. **Importante:** disponibilidad comercial, precio, velocidad, experiencia de usuario y calidad de integración deben analizarse por separado. **Veredicto RankIA:** Claude Opus 5.5 encabeza esta selección en capacidad evaluada. La elección para un proyecto real requiere comparar también costos, disponibilidad y resultados en tareas específicas.

# RankIA — Octubre 2026 ## La batalla por la inteligencia artificial más avanzada La competencia entre los principales desarrolladores de inteligencia artificial continúa acelerándose. Anthropic, OpenAI y Google están impulsando nuevas generaciones de modelos capaces de resolver problemas cada vez más complejos. Pero ¿cuál ofrece realmente el mejor desempeño? Para esta edición de RankIA utilizamos el **Artificial Analysis Intelligence Index**, una evaluación independiente que combina pruebas de razonamiento, conocimiento, programación y resolución de tareas complejas. ### Los resultados destacados **Claude Opus 5.5 — 58 puntos** El modelo con mayor puntuación en la selección analizada, configurado con esfuerzo máximo. Su posición refleja un desempeño sobresaliente en el conjunto de pruebas evaluadas. **Claude Sonnet 5.5 — 56 puntos** Se sitúa cerca de Opus 5.5 y demuestra que un modelo de una categoría distinta puede ofrecer resultados competitivos. **GPT-6 Astra — 53 puntos** La propuesta de OpenAI se mantiene entre los modelos de mayor capacidad, con resultados destacados en evaluaciones técnicas y de razonamiento. **Claude Fable 5.1 — 53 puntos** Comparte puntuación redondeada con GPT-6 Astra y confirma la presencia de varios modelos de Anthropic en los primeros niveles de capacidad. **Gemini 4 Argon — 53 puntos** La propuesta de Google iguala a otros modelos de frontera en puntuación redondeada. Su disponibilidad limitada es un factor relevante para quienes buscan utilizarlo en proyectos. **GPT-6.1 Sol — 52 puntos** Otra alternativa de OpenAI que aparece muy cerca de los modelos líderes, demostrando que las diferencias en capacidad medida no siempre son amplias. ### ¿Qué significa realmente este ranking? Una puntuación superior no garantiza que un modelo sea el mejor para cualquier necesidad. El índice mide capacidades mediante una metodología específica. No equivale a una prueba directa de satisfacción, productividad empresarial, facilidad de uso o rentabilidad. Por eso, al seleccionar una herramienta de IA también debemos considerar el costo, la velocidad, la disponibilidad, la privacidad y la posibilidad de integrarla con nuestros procesos. ### El ángulo de Daniel Lucas La verdadera ventaja competitiva no consiste en contratar siempre la IA con la puntuación más alta. Consiste en comprender el problema, formular correctamente las instrucciones, elegir el modelo apropiado y medir los resultados. Para una empresa, una pequeña mejora en una prueba académica puede tener menos valor que una automatización confiable que reduzca trabajo repetitivo. **La mejor IA no necesariamente es la más poderosa. Es la que resuelve mejor tu problema.** ### Metodología y fuentes Datos de referencia: Artificial Analysis Intelligence Index, versión 4.3.2, corte consultado del 7 de octubre de 2026. Se utilizan las configuraciones Max de Claude Opus 5.5, Claude Sonnet 5.5, Claude Fable 5.1, GPT-6 Astra y GPT-6.1 Sol, así como la configuración High de Gemini 4 Argon. Las puntuaciones están redondeadas a enteros. Los empates representan puntuaciones publicadas iguales, no necesariamente un rendimiento idéntico. Fuente principal: https://artificialanalysis.ai/ Este artículo presenta resultados de terceros; Apex AcademIA no afirma haber realizado las pruebas originales. --- **Apex AcademIA** Inteligencia artificial, talento humano.

#RankIA #Benchmark IA #Inteligencia Artificial #Modelos de IA #Claude #ChatGPT #GPT-6 #Gemini #Anthropic #OpenAI #Google #Comparativa IA #Apex AcademIA #Ranking IA 2026